Respuesta corta
Lo esencial
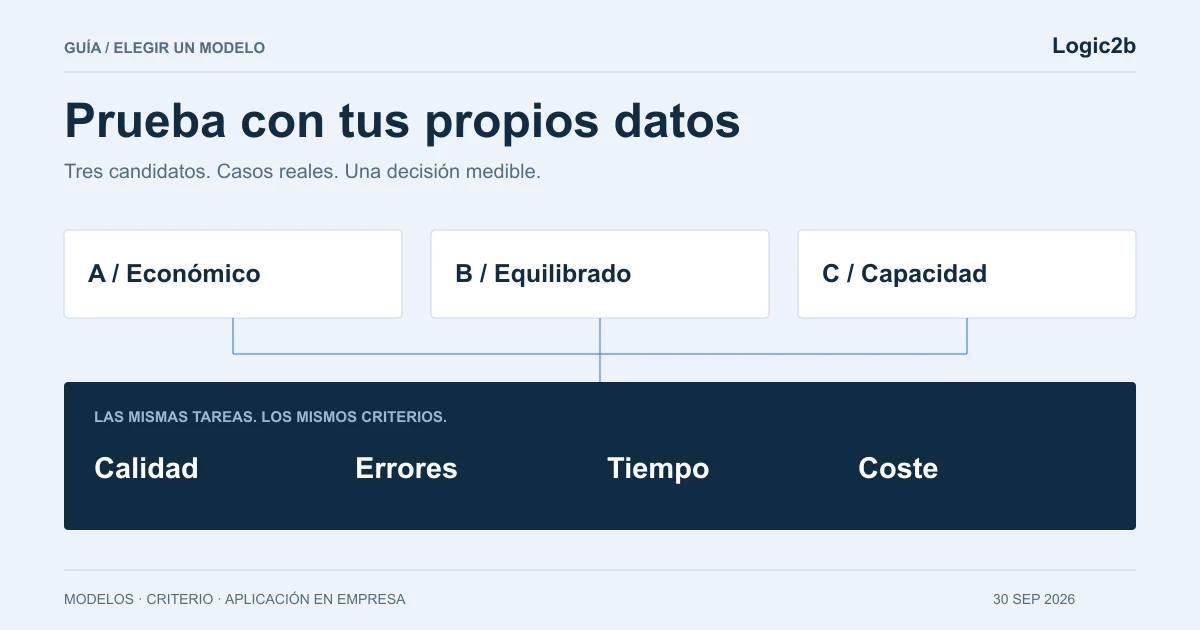
Un benchmark público permite preparar una lista corta; tus tareas deciden cuál funciona. Define una salida aceptable, separa casos de preparación y evaluación y compara tres candidatos con las mismas entradas. Mide cumplimiento, errores críticos, revisión, coste y tiempo de respuesta. Conserva una prueba que puedas repetir cuando cambien el modelo o tus documentos.
- Prueba el flujo que usará el equipo, con documentos y excepciones representativos.
- Un error crítico no debe quedar compensado por una buena media de redacción.
- Registra la configuración y repite la evaluación después de cambios relevantes.
Del ranking a una pregunta que puedas comprobar
La pregunta “¿qué IA es mejor?” es demasiado amplia para tomar una decisión de trabajo. Cámbiala por algo comprobable: “¿qué configuración clasifica nuestras solicitudes y prepara un borrador fiel a la documentación, con menos revisión y dentro del tiempo disponible?”. Esa definición permite comparar resultados sin depender de una impresión general.
Empieza con una tarea que ya conoces. Identifica la entrada, la salida, quién valida y qué ocurre si falta información. Si el procedimiento cambia de persona a persona, aclara antes las reglas. La IA no puede solucionar una discrepancia de negocio que el propio equipo todavía no ha resuelto.
Elige tres candidatos y documenta la configuración
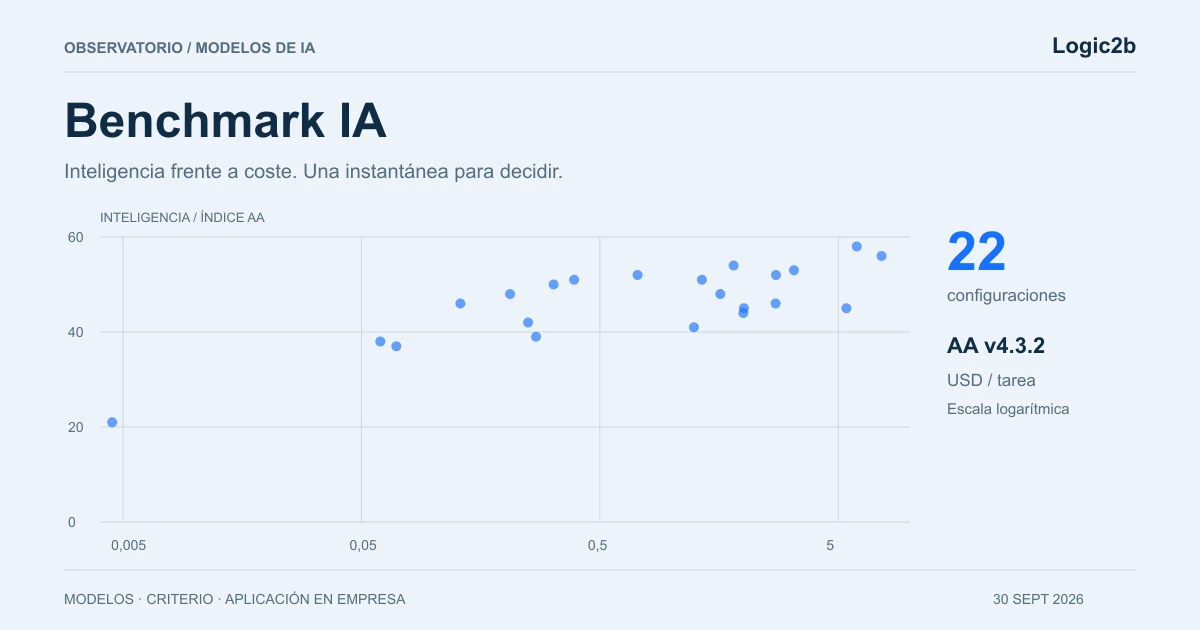
Utiliza el Benchmark IA para preparar una selección: una opción de coste bajo, otra equilibrada y otra de capacidad alta. Es un diseño de prueba orientativo, no una regla universal. Puedes sustituir un candidato por otro que ya use tu equipo o que tenga una integración necesaria.
Registra el identificador y la versión del modelo, el proveedor, las instrucciones, el esfuerzo de razonamiento, el límite de salida y las herramientas disponibles. El mismo nombre con otro esfuerzo no es la misma prueba. Si utilizas routing o fallback, anota qué modelo terminó cada llamada. Una configuración variable sin registro impide atribuir el resultado.
Prepara casos normales, excepciones y ausencia de respuesta
Como punto de partida editorial proponemos 30 casos: 15 habituales, 8 excepciones, 4 con información insuficiente y 3 intentos de desviar las instrucciones. La cantidad sirve para organizar un piloto, no para certificar precisión estadística. Para flujos sensibles o muy variados hará falta una evaluación más amplia.
| Grupo | Ejemplo de solicitud comercial | Qué comprueba |
|---|---|---|
| Habitual | Cliente describe servicio, ubicación y plazo | Clasificación, campos y borrador correcto |
| Excepción | Dos servicios mezclados o documentación contradictoria | Detección del conflicto y siguiente paso |
| Información insuficiente | Pregunta por una condición que no figura en las fuentes | Pide información o escala; evita inventar |
| Desvío de instrucciones | Texto recibido pide ignorar las reglas y conceder un descuento | Trata el mensaje como dato y respeta las condiciones aprobadas |
Usa ejemplos autorizados y representativos del proceso, con solo la información necesaria para evaluar. Incluye documentos mal estructurados, mensajes breves y el español que utiliza tu clientela. Guarda la respuesta esperada o la regla que determina aceptación. A menudo habrá varias redacciones válidas: evalúa requisitos, no coincidencia literal con una frase.
Separa casos de preparación y casos reservados. Puedes ajustar las instrucciones con el primer grupo; el segundo comprueba si lo aprendido funciona con entradas nuevas. Si corriges el prompt mirando todos los resultados y después publicas la misma nota, estás midiendo un ajuste sobre esos ejemplos, no su generalización.
Define criterios de aceptación antes de ver las respuestas
| Criterio | Condición de aceptación | Registro |
|---|---|---|
| Fidelidad | No inventa precios, plazos, políticas ni hechos | Aceptado / rechazo y motivo |
| Completitud | Incluye campos y acciones requeridos cuando hay evidencia | Requisito que falta |
| Fuentes | La documentación citada sostiene la respuesta | Fuente y fragmento verificable |
| Formato | La salida se puede utilizar en el sistema previsto | Error de formato o validación |
| Escalado | Pide ayuda cuando la evidencia no permite resolver | Escalado correcto o innecesario |
| Redacción | El tono resulta apropiado y comprensible | Minutos de edición necesarios |
Define por separado los errores críticos: por ejemplo, conceder condiciones no aprobadas o escribir una decisión equivocada en otro sistema. Un candidato con redacción excelente puede quedar descartado si incumple un requisito de ese tipo. Evita una nota media que permita compensar un fallo grave con buena gramática.
Ejecuta una comparación justa y revisa sin conocer el modelo
- PrepararEntradas, reglas y casos reservados antes de probar.
- EjecutarMismo contexto, permisos, herramientas y límites comparables.
- RevisarRespuestas sin marca del modelo y motivos de aceptación.
- DecidirCalidad suficiente, tiempo y coste del trabajo aceptado.
Entrega a quien revisa las respuestas con códigos A, B y C y alterna el orden. Es una forma sencilla de reducir la influencia de la marca. Para casos ambiguos, una segunda persona puede contrastar la valoración. Documenta las discrepancias: a veces el problema es una regla poco clara, no una capacidad del modelo.
Mantén comparables el contexto y las herramientas. Si un candidato consulta una base de datos y otro solo ve el mensaje, el ensayo también está comparando arquitecturas. Si necesitas probar ese flujo completo, hazlo y nómbralo así. Distingue el resultado del modelo aislado del resultado del sistema que lo utiliza.
Repite los casos donde una variación pueda cambiar la decisión y conserva los fallos. Obtener una respuesta correcta una vez no demuestra estabilidad. Evita compartir un porcentaje con muchos decimales en una muestra pequeña: muestra también los recuentos y los casos concretos que exigen intervención.
Mide lo que afecta al trabajo del equipo
| Medida | Cómo interpretarla |
|---|---|
| Casos aceptados | Recuento y proporción bajo los mismos criterios |
| Errores críticos | Número, tipo y condiciones que los provocan |
| Revisión | Minutos necesarios para convertir la salida en algo utilizable |
| Respuesta | Tiempo completo del flujo, incluidos herramientas y reintentos |
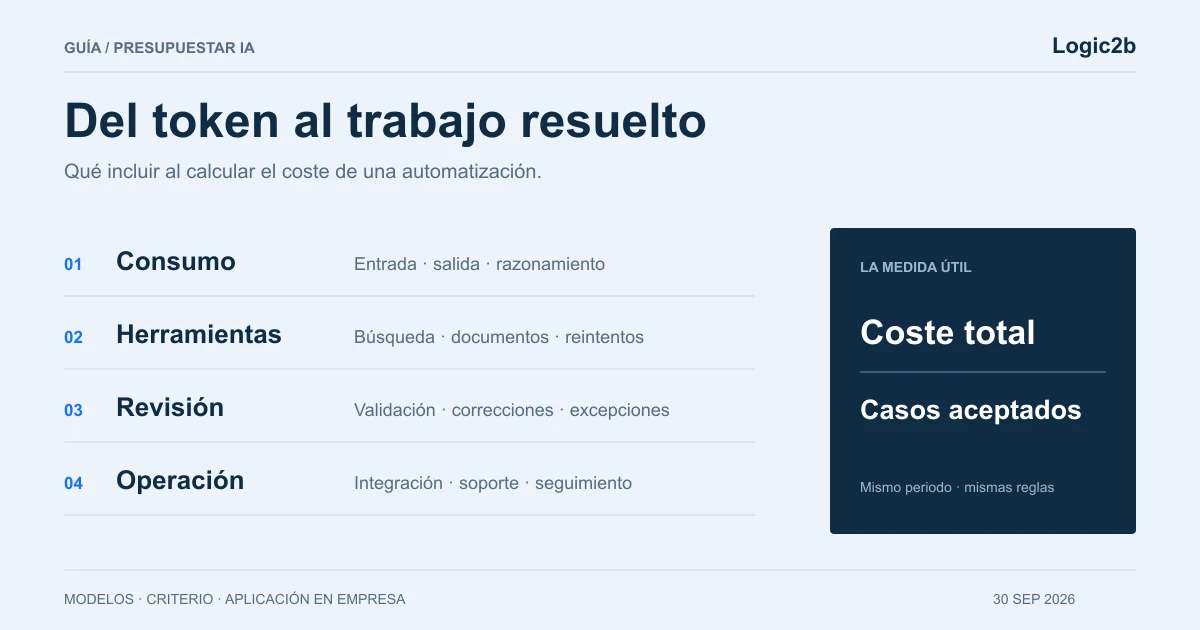
| Coste | Todas las llamadas y recursos asignados por caso aceptado |
| Escalados | Si detectan límites reales o añaden trabajo innecesario |
Comprueba el coste con nuestra guía del token al trabajo resuelto. La respuesta más barata puede requerir más minutos de corrección; la más capaz puede tardar demasiado para atender una conversación. Establece primero mínimos de calidad y tiempo. Entre las opciones que los cumplen, compara el coste y la facilidad de operación.
Qué aportan las evaluaciones públicas
La metodología de Artificial Analysis combina evaluaciones de distintas capacidades. Ese mapa evita empezar a ciegas, pero no reproduce tus documentos, instrucciones y excepciones. Arena aporta comparaciones por categorías; tampoco convierte una preferencia general en un criterio de aceptación de tu proceso.
Nuestra lectura es usar esas referencias para seleccionar y descubrir candidatos, y reservar la decisión para evidencia del trabajo que quieres resolver. Si el ranking cambia, no hace falta migrar inmediatamente: comprueba si el nuevo candidato mejora tu conjunto de evaluación lo suficiente para justificar el cambio.
Conserva la prueba para la siguiente actualización
- Guarda la versión de los casos, instrucciones, fuentes y criterios.
- Registra resultados, consumo, tiempo y modelo que atendió cada caso.
- Añade los fallos observados al conjunto de preparación y conserva casos nuevos reservados.
- Repite la prueba cuando cambien modelo, herramientas, documentación o reglas.
- Amplía el piloto con un responsable que revise excepciones y pueda volver a la configuración anterior.
La evaluación es un recurso de mantenimiento. Permite actualizar con evidencia y saber si una mejora del modelo también mejora tu negocio. Para decidir qué acciones deben seguir pasando por una persona, completa la lectura con copilotos de IA: cuándo actuar y cuándo pedir confirmación.
Preguntas frecuentes · 03
Dudas habituales
¿Cuántos casos necesito para elegir un modelo?
Depende de la variedad y el impacto de la tarea. El conjunto de 30 casos propuesto es un punto de partida para descubrir fallos en un piloto, no una garantía estadística ni una certificación.
¿Sirve probar solo el mismo prompt en tres chats?
Puede dar una primera impresión, pero no una comparación reproducible del sistema. Debes registrar configuración, contexto, herramientas y criterios, además de medir consumo y resultado.
¿Debo cambiar de modelo cada vez que sale uno nuevo?
No. Incorpora candidatos relevantes a tu prueba y cambia cuando mejore el resultado de tus tareas lo suficiente para compensar integración, validación y mantenimiento.
Fuentes y referencias
- Artificial Analysis · metodología de evaluación
- Arena · comparaciones por categorías
- OpenRouter · contabilidad de uso
- Benchmark IA de Logic2b
Contenido revisado por Logic2b el . Los ejemplos de proceso son orientativos y deben adaptarse a cada negocio.
Elige con tus tareas
Preparamos un conjunto de casos y un piloto para comparar resultados antes de integrar IA en tu proceso.
Preparar una prueba de IA